一、引言:大模型时代的算力挑战
随着ChatGPT、DeepSeek、Llama等万亿级参数大模型的涌现,人工智能训练对算力的需求呈现指数级增长。据OpenAI测算,2012年至2018年间,AI训练算力每3.4个月翻一番,远快于摩尔定律。进入大模型时代,单次训练任务动辄需要数千张GPU、持续数周乃至数月,算力集群规模已从单机多卡演进到万卡乃至十万卡级别。
简单堆砌硬件并不等于获得有效算力。大模型训练的实际效率,取决于芯片、网络、存储、软件栈与调度系统的深度协同。这正是“软硬协同智算集群”理念的核心——以系统工程思维,将异构算力、高速互联、分布式存储和基础软件统一编排,构建面向大模型训练的高效基座。
本文将聚焦AI大模型训练的算力需求,解析软硬协同智算集群的架构要点,并探讨人工智能基础软件在这一体系中的关键作用。
二、大模型训练的算力特征
2.1 算力密度要求极高
大模型训练本质上是海量矩阵乘法与归约操作的迭代。以GPT-3 175B为例,完整训练约需3.14×10²³ FLOPs。若要在合理时间内完成,集群需提供百PFLOPs级(FP16)的有效算力。这要求单卡具备高Tensor Core吞吐,单机内多卡通过NVLink等实现高带宽互联,机间则依赖RDMA网络构建无损传输。
2.2 通信是效率瓶颈
数据并行、流水线并行、张量并行、专家并行等策略将模型切分到数千张卡上。每轮迭代都需要梯度同步、激活值传递或All-Reduce操作。若网络带宽不足或延迟过高,GPU将大量时间花在等待数据上,算力利用率(MFU)可能从60%骤降至20%以下。可以说,大模型训练的一大半难题是通信问题。
2.3 存储与数据供给需匹配
训练数据动辄数十TB,样本读取、预处理、增强均需高吞吐存储系统支撑。若I/O跟不上,GPU就会“饿死”。Checkpoint的频繁写入(尤其大模型)对存储带宽提出高要求,故障恢复时间也成为影响有效算力的关键变量。
2.4 异构与弹性调度成为常态
现实中,集群往往混合多种GPU型号,甚至CPU、NPU共存。任务可能因资源调整而被抢占或迁移。这要求软件层具备异构资源抽象、拓扑感知调度和容错恢复能力。
三、软硬协同智算集群的架构层次
3.1 硬件层:算力、互联与存储
- 算力单元:GPU/TPU/NPU等加速器,提供高密度的矩阵计算能力。当前主流AI芯片通过Tensor Core、更大HBM容量与更高HBM带宽提升单卡性能。
- 节点内互联:NVLink/NVSwitch、Infinity Fabric等提供600GB/s至1.8TB/s的GPU间带宽,是张量并行的物理基础。
- 集群网络:RDMA over Converged Ethernet (RoCE)或InfiniBand,构建无阻塞Fat-Tree或Torus拓扑,实现集体通信库(NCCL)的高效All-Reduce。
- 存储层:并行文件系统(如Lustre、GPFS、WEKA)和对象存储,配合本地NVMe缓存,满足高吞吐、低延迟的数据读写。
3.2 系统软件层:驱动、通信与运行时
- 驱动与固件:CUDA/ROCm等提供编程接口,版本匹配直接影响稳定性与性能。
- 通信库:NCCL、HCCL、Gloo等实现集合通信原语,其算法选择与拓扑感知优化直接决定扩展效率。
- 容器与编排:Docker、Kubernetes 提供资源隔离与调度基础;RDMA设备插件、GPU Operator实现异构硬件的统一纳管。
- 监控与诊断:DCGM、Prometheus、Grafana 实时采集GPU利用率、显存、温度、网络吞吐等指标,用于性能分析与故障定位。
3.3 AI框架与训练平台
- 主流框架:PyTorch、TensorFlow、JAX、PaddlePaddle 等提供模型定义与自动微分。PyTorch凭借动态图和生态优势成为大模型训练事实标准。
- 分布式策略集成:DeepSpeed、Megatron-LM、FairScale、Colossal-AI 等将数据并行、张量并行、流水线并行、ZeRO优化封装,降低大模型并行开发门槛。
- 训练平台:阿里PAI、华为ModelArts、火山引擎Volcano、Kuai等提供任务提交、队列管理、优先级抢占、弹性伸缩和容错机制。
3.4 算子与编译优化
- 融合算子:将多个Element-wise操作、矩阵乘与激活函数融合,减少显存搬运和kernel launch开销。
- AI编译器:TVM、TensorRT、ONNX Runtime、XLA等将计算图映射到特定硬件,进行算子融合、内存复用、指令调度优化。
- 自动调优:AutoTVM、Ansor等搜索最优算子实现,在给定硬件上逼近峰值性能。
四、软硬协同的关键技术实践
4.1 拓扑感知调度
调度器需了解GPU间NVLink连接关系、节点间网络层级、存储挂载点,将通信密集的任务就近放置。例如,张量并行组应尽量调度到同一NVLink域内,数据并行组在跨机时需保证带宽充足。Kubernetes的拓扑管理器与NUMA感知已提供初步支持,结合自定义调度器实现更细粒度匹配。
4.2 计算-通信重叠
通过流水线并行将小批次切分为微批次,使前向反向计算与All-Reduce、Send-Recv等通信操作在不同流中重叠执行。Megatron-LM、DeepSpeed等框架已内置此类优化,配合GPUDirect RDMA与异步通信,可将通信开销隐藏在计算之下。
4.3 显存优化与混合精度
ZeRO(零冗余优化器)将优化器状态、梯度、参数分片到不同GPU,大幅降低单卡显存占用。混合精度训练以BF16/FP16进行计算、FP32保留主权重,兼顾速度与数值稳定。量化训练与参数高效微调(LoRA、QLoRA)进一步降低显存需求。
4.4 容错与弹性训练
万卡集群故障是常态而非意外。检查点分片保存、异步写入、快速重启,以及弹性训练框架(如TorchElastic)可在节点失效后重新组建集群,从中断点恢复,显著减少有效算力浪费。
4.5 性能剖析与持续调优
Nsight Systems、昇腾Profiling、PyTorch Profiler等工具可定位通信阻塞、内存拷贝、算子瓶颈。MFU是衡量大模型训练综合效率的黄金指标,软硬协同的最终目标就是不断提升MFU,让集群既“算得快”又“跑得稳”。
五、人工智能基础软件的战略价值
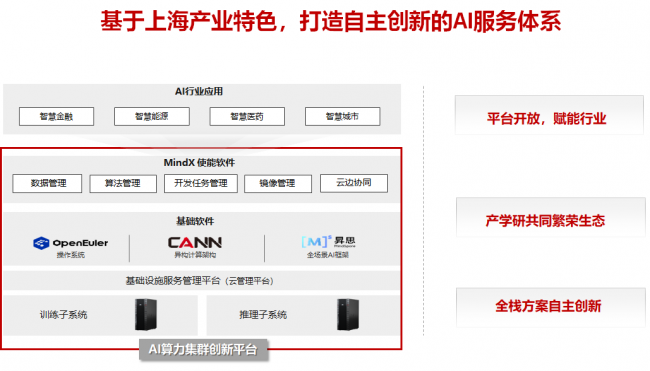
人工智能基础软件是连接芯片与应用的“操作系统”。它决定了异构硬件的易用性、算力调度的灵活度和训练推理的整体效率。在我国算力芯片多元化、生态尚在建设期的背景下,基础软件的战略意义尤为突出:
- 屏蔽硬件差异:统一编程接口与算子库,使上层框架不需为每类芯片单独适配,降低模型迁移成本。
- 释放硬件潜能:通过编译器、通信库和运行时的深度优化,将纸面算力转化为实际有效算力。
- 构建生态护城河:以开源框架、社区标准和异构计算接口带动全栈协同,形成从芯片到应用的黏性。
当前,PyTorch仍占据主导,但国产框架与芯片厂商正加速构建自主软件栈。例如,华为昇腾的CANN、百度的PaddlePaddle、寒武纪的BANG、摩尔线程的MUSA,皆在探索软硬协同的高效路径。开放标准如OpenXLA、MLIR、UXL等亦在为跨硬件基础软件提供新选项。
六、案例视角:大规模集群中的协同优化
以某千卡级A100集群训练百亿参数模型为例,初始MFU仅28%。优化团队分层入手:
- 网络层:启用RoCE无损网络,调整PFC/ECN参数,使All-Reduce带宽提升40%。
- 并行策略:采用张量并行4 × 流水线并行8 × 数据并行32,匹配NVLink域与节点边界,减少跨机通信。
- 显存优化:启用ZeRO-3与梯度检查点,单卡batch size从2提升至8。
- 算子优化:融合LayerNorm与Dropout,FlashAttention加速注意力计算,每步迭代时间缩短22%。
- 容错设计:Checkpoint分片存入WEKA存储,故障后5分钟内恢复。
综合调整后,MFU提升至52%,训练时间从预估42天压缩到21天。该案例说明,软硬协同不是单一技术的突破,而是系统各层面的精细化匹配与持续迭代。
七、未来趋势
- 超异构融合:CPU、GPU、NPU、DPU协同计算,DPU卸载网络与存储协议栈,提升整体效率。
- 液冷与绿色算力:高密度集群散热与能耗管理,PUE降至1.1以下,算力与双碳目标协同。
- 存算一体与近存计算:打破内存墙,进一步提升能效比。
- 标准化与开放生态:PyTorch 2.x编译栈、OpenXLA、无服务器GPU等加速软硬解耦。
- AI for System:利用机器学习预测故障、优化调度、自动调参,降低大集群运维复杂度。
八、
大模型训练推动算力集群走向万卡规模,但“堆硬件”时代已近尾声。未来算力的竞争,本质上是软硬协同能力的竞争——谁能将芯片、网络、存储与基础软件深度集成,化为稳定高效的生产力,谁就能在AI大模型的征途中夯实底座。人工智能基础软件并非附属品,而是释放算力、繁荣生态的核心基础设施。唯有软硬协同、体系化推进,才能支撑智算集群从“电费黑洞”走向“价值引擎”。